
То ли я дурак то ли AtmelStudio6 тупая (проблема USART)
 Всем привет.
День назад на форуме в одном из топиков задал вопрос, а ответа ждать терпения не хватает может здесь быстрее вы его мне дадите…
Репост с форума:
Решил не создовать новым топик с вопросом обращаюсь сюда…
Раньше пользовался левой библиотекой и все устраивало но сейчас в целях экономии написал компактно инициализацию USART ручками по примеру даташита и тут такой баг не понимаю может вы объясните.
Собственно в виртуальном отладчике на строчке:
UCSRC = (1<<URSEL)|(1<<USBS)|(1<<UCSZ1);
Студия ни фига в битах не выставляет после прохождения именно этой строчки то есть UBRRL и UCSRC он выставляет как надо.
В железе, а это ATmega8, проверить пока нет возможности=(
В чем может быть беда???
Визуализация проблемы:
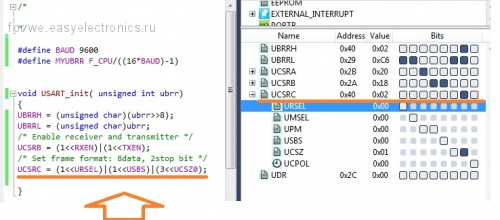
К тому же обнаружился глюк почему то в место F_CPU он подставляет 1000000UL хотя у меня четко прописано #define F_CPU 16000000UL.
Проверил работу этого кода на разных машинах везде эта хрень что может быть???
- 0
- 03 сентября 2012, 18:45
- michaeltex
Дефайн нужно прописывать в конфигах а не в коде. Он перебивается.
Софтварная отладка всегда глючила.
Софтварная отладка всегда глючила.

Спасибо учту. Хотя все равно не понятно в delay.h он берет правильное значение и дальше по коду и в хидерах не встречается #define F_CPU.

- michaeltex
- 04 сентября 2012, 13:26
- ↑
- ↓
Что значит берет правильное значение? В delay.h есть следующий код:
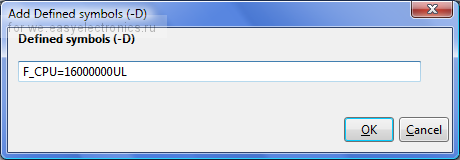
F_CPU можно, конечно, определить через #define и прямо в коде программы, но он должен быть определён до всех #include файлов, которые используют его. Или его можно определить в настройках компилятора, что более правильно: пункт меню Project -> Properties… -> Toolchain -> AVR/GNU C Compiler -> Symbols
#ifndef F_CPU
/* prevent compiler error by supplying a default */
# warning "F_CPU not defined for <util/delay.h>"
# define F_CPU 1000000UL
#endifF_CPU можно, конечно, определить через #define и прямо в коде программы, но он должен быть определён до всех #include файлов, которые используют его. Или его можно определить в настройках компилятора, что более правильно: пункт меню Project -> Properties… -> Toolchain -> AVR/GNU C Compiler -> Symbols
Или его можно определить в настройках компилятора, что более правильно: пункт меню Project -> Properties… -> Toolchain -> AVR/GNU C Compiler -> SymbolsКстати, в пятой студии я так и не нашел, как определить F_CPU так, чтобы его видели и ассемблер, и С/С++ компилятор. Хоть тресни — только компилер видит. Пришлось вбивать определение F_CPU в хедер конфигурации V-USB, иначе его асмовая часть отказывалась компилироваться.
В 6-й это пофиксили?

When writing to UCSRC, the value will be copied to UBRRH unless bit 7 is also set in in the same write operation. This behaviour is erroneous on devices that have separate locations for these registers. Another workaround is to write UBRRH after UCSRC.… это в 4-ой студии. Посмотрите в хелпе раздел «Known Issues in AVR Simulator»


По-моему, в формуле вычисления MYUBRR ошибка: единица должна отниматься от результата деления, а не быть в знаменателе:
#define MYUBRR F_CPU/(16*BAUD)-1#define MYUBRR ((F_CPU + 16*BAUD/2)/(16*BAUD)-1)
скажите, это я дурак, или у вас действительно в коде на самом деле написано UCSRC = (1<<URSEL)|(1<<USBS)|(3<<UCSZ1); ??

в данном случае да, но вообще нехорошо так делать — а если USBS выставлять в 1 не надо?
уж битовые маски так битовые маски, или тогда писать так UCSRC=0x8C
пардон за ворчливость
уж битовые маски так битовые маски, или тогда писать так UCSRC=0x8C
пардон за ворчливость
Так устанавливают двухбитовые поля — т.е. в данном случае биты UCSZ1 и UCSZ2. Т.е. эту запись нужно понимать как «выставить UCSZ в 0b11».
Пожалуй, не соглашусь.
Ибо так можно при туплении в код сразу увидеть какой бит выставлен, а какой нет, и немедленно сравнить с даташитом.
Не напрягая голову конструкциями типа UCSRC=0x8C, до которой при подобном подходе недалеко остаётся.
Но это все лирика, конечно.
Ибо так можно при туплении в код сразу увидеть какой бит выставлен, а какой нет, и немедленно сравнить с даташитом.
Не напрягая голову конструкциями типа UCSRC=0x8C, до которой при подобном подходе недалеко остаётся.
Но это все лирика, конечно.
Конечно знает)
Неоднократно повторявшаяся ситуация — вот понадобилось мне, допустим, спустя год залезть в какой-то старый проект на AVR, и что-то там поправить или дописать. А последние месяцев 8 я работал, допустим, с MSP430 и TMS320F28xx, и как там что в AVR — давно вылетело из головы. При задании нужного значения отдельными битами я разберусь в коде, быстренько глянув в даташит, а при задании его числом мне надо будет что-то там думать, соображать, и терять на этом время. Поэтому извращения — наше всё:)
Неоднократно повторявшаяся ситуация — вот понадобилось мне, допустим, спустя год залезть в какой-то старый проект на AVR, и что-то там поправить или дописать. А последние месяцев 8 я работал, допустим, с MSP430 и TMS320F28xx, и как там что в AVR — давно вылетело из головы. При задании нужного значения отдельными битами я разберусь в коде, быстренько глянув в даташит, а при задании его числом мне надо будет что-то там думать, соображать, и терять на этом время. Поэтому извращения — наше всё:)
То есть ты посчитаешь делитель, переведешь его в двоичный код, забьешь побитово, а когда захочешь поправить — переведешь обратно в десятичный, пересчитаешь, переведешь в двоичный и забьешь? Не говоря уже о том, что в этой строчке запросто можно ошибиться. Я даже не уверен, не ошибся ли я и действительно ли эта строчка выставит делитель равным 51.
Месье знает толк не только в извращениях, но и в написании нечитабельного кода!
Месье знает толк не только в извращениях, но и в написании нечитабельного кода!
Я не имел в виду перенос на другой МК, я имел в виду по-быстрому разобраться в старом коде, не сильно напрягая голову и не сильно проверяя собственную внимательность — лучше уж я сразу напишу максимально понятно. По тем же причинам, кстати, я никогда не использую uint_8 и т.п., а пишу полностью, допустим, unsigned char.
char — символьный тип. Даже если полагать, что все архитектуры с не-восьмибитным байтом повымерли — в принципе, char может иметь другую разрядность — скажем 16 или 32 бита.
Еще есть тип byte. ЕМНИП, он равен char'у по разрядности. Причем sizeof() возвращает размер именно в размерах byte/char.
Похожая, но более общеизвестная веселуха с типами int, long и т.п.
А еще бывает так, что на одних архитектурах быстрее работать с 8-битной переменной, а на других — с 32-битной. Для этого придумали uint8_fast_t, который имеет наиболее оптимальную для архитектуры разрядность, которая не меньше заданной.
Еще есть тип byte. ЕМНИП, он равен char'у по разрядности. Причем sizeof() возвращает размер именно в размерах byte/char.
Похожая, но более общеизвестная веселуха с типами int, long и т.п.
А еще бывает так, что на одних архитектурах быстрее работать с 8-битной переменной, а на других — с 32-битной. Для этого придумали uint8_fast_t, который имеет наиболее оптимальную для архитектуры разрядность, которая не меньше заданной.
madmazy да действительно написано 3 это взято копипастом из даташита…
- michaeltex
- 04 сентября 2012, 13:16
- ↑
- ↓
Спасибо John за подсказку по формуле. А правила форума, angel5a , прочту!
Вообщем всем спасибо что отозвались…
Вообщем всем спасибо что отозвались…
- michaeltex
- 04 сентября 2012, 13:21
- ↓


Комментарии (46)
RSS свернуть / развернуть